Los LLM ya no son experimentos de laboratorio. Están integrados en producción, con acceso a datos internos, herramientas y flujos de trabajo críticos. Pero la seguridad no ha avanzado al mismo ritmo que la adopción. La mayoría de las mitigaciones actuales son reactivas y se concentran en la fase de inferencia, dejando descubiertas las etapas de entrenamiento y las dependencias de la cadena de suministro.
Este artículo no es una introducción teórica a los riesgos de la IA. Es una guía operativa para quienes despliegan LLM en entornos reales y necesitan saber qué atacar primero y cómo hacerlo sin frenar la innovación. Si vienes del mundo de la ciberseguridad clásica, te resultará útil nuestra guía completa de ciberseguridad como marco general; aquí nos centramos en la capa específica de los modelos de lenguaje.
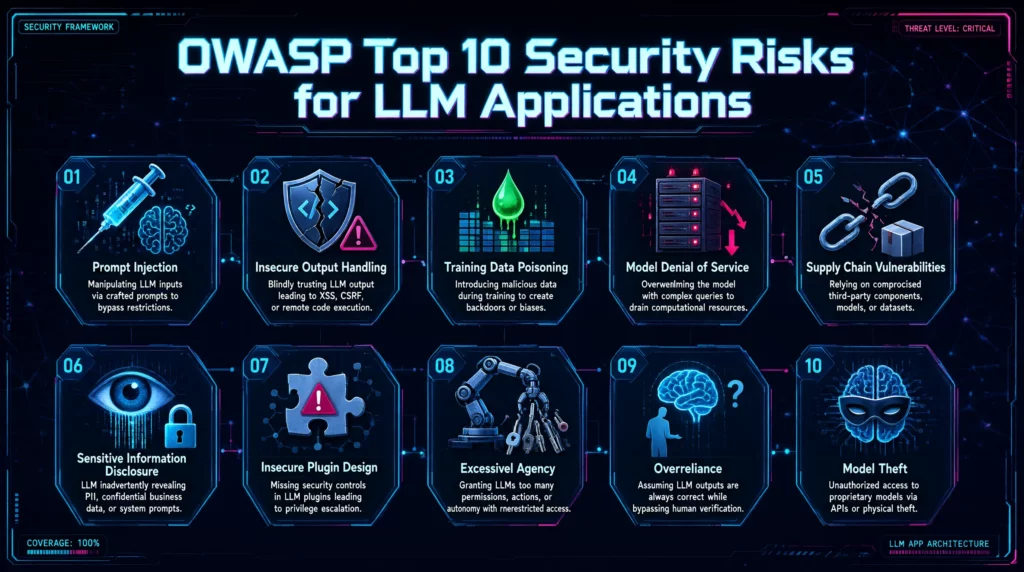
1. El mapa de riesgos: OWASP Top 10 para LLM (2026)
La edición 2026 del OWASP Top 10 para aplicaciones LLM mantiene en cabeza dos riesgos clásicos: Prompt Injection y Divulgación de Información Sensible. Pero el cambio más relevante es el ascenso de la agencia excesiva (LLM03) y la ampliación de la fuga de contexto oculto (LLM08), reflejo directo de que los LLM ya no solo generan texto: ejecutan acciones.
Los riesgos que más impactan en producción hoy son:
- Prompt Injection (LLM01): el atacante inserta instrucciones maliciosas en el contexto del modelo, ya sea en un documento, una página web o un correo que el LLM procesa.
- Agencia Excesiva (LLM03): el agente tiene más permisos de los que necesita. Si es manipulado, el daño escala desde «respuesta incorrecta» hasta «comando ejecutado en el servidor».
- Fuga de Información Sensible (LLM02): el modelo revela datos confidenciales que estaban en su contexto o en sus datos de entrenamiento.
- Manejo Inseguro de Salidas (LLM05): el código o las acciones generadas por el LLM se ejecutan sin validación suficiente.
Punto clave: no todos los riesgos merecen la misma inversión inmediata. La priorización debe basarse en el impacto operativo real de tu despliegue concreto. Un chatbot de soporte que solo lee documentación pública tiene un perfil de riesgo muy distinto a un agente que puede enviar correos y ejecutar comandos.
Si te interesa la otra cara de la moneda —usar IA para defenderte en lugar de para atacar—, tenemos un artículo dedicado a machine learning aplicado a la detección de amenazas.
2. Defensa en capas: dónde poner cada barrera
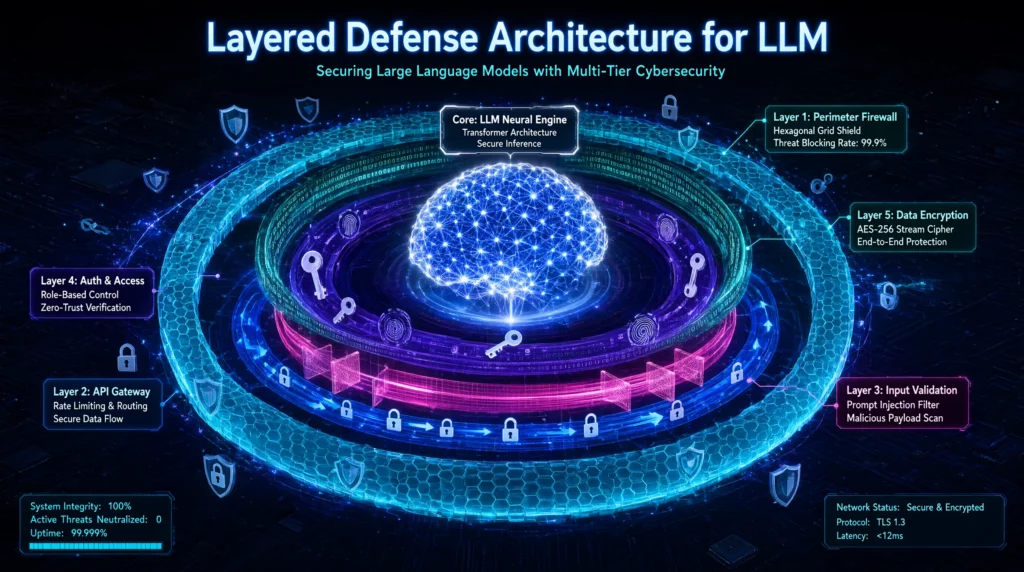
La seguridad de un LLM no se resuelve con un solo control. Necesitas capas independientes que se complementen. Si una falla, la siguiente debe contener el daño.
Capa de entrada (input)
- Marca todo contenido externo (documentos subidos, resultados de búsqueda, correos) como no confiable.
- Nunca ejecutes instrucciones que provengan de fuentes externas al sistema. El modelo debe tratar ese contenido como dato, no como instrucción.
- Filtra y sanea entradas antes de que lleguen al contexto del modelo.
Capa de herramientas (tools)
- Cada herramienta que el agente pueda invocar debe tener credenciales propias y de mínimo privilegio.
- Ejecuta las herramientas en sandbox, nunca con los permisos del sistema anfitrión. Si tus herramientas corren en contenedores, revisa nuestra introducción a la seguridad de contenedores en Docker y Kubernetes.
- Define una allowlist explícita de herramientas y funciones permitidas. Lo que no está en la lista, no existe para el agente.
Capa de decisión (policy)
- Las acciones de alto impacto (borrar datos, enviar correos externos, ejecutar pagos, modificar configuraciones) requieren confirmación humana o un policy gateway determinista.
- Separa el razonamiento del agente de la ejecución: el agente propone, el gateway valida y ejecuta.
Capa de observabilidad
- Registra cada paso de la cadena de razonamiento y cada llamada a herramienta. Sin trazabilidad no hay forense posible.
- Alerta sobre patrones anómalos: intentos repetidos de acceder a herramientas no autorizadas, prompts que intentan mapear el sistema (reconocimiento de IA).
3. Prompt Injection: por qué el filtrado simple no basta
La inyección de prompts no es un problema resuelto con un regex. Los ataques modernos incluyen:
- Instrucciones ocultas en HTML, metadatos o texto que el LLM procesa pero el usuario no ve.
- Ataques de múltiples pasos donde el primero parece inofensivo y prepara el terreno para el segundo.
- Reconocimiento previo: el atacante prueba qué herramientas tiene el agente, qué permisos maneja y qué rechaza, antes de lanzar el ataque real.
Medida práctica: trata todo output del LLM que vaya a ejecutarse (código, comandos, llamadas a API) como entrada no confiable. Valida, sanea y limita antes de ejecutar. OWASP lo clasifica como «Manejo Inseguro de Salidas» precisamente porque el error más común es confiar en que el modelo «sabe lo que hace».
4. El policy gateway: el control que separa razonamiento de ejecución
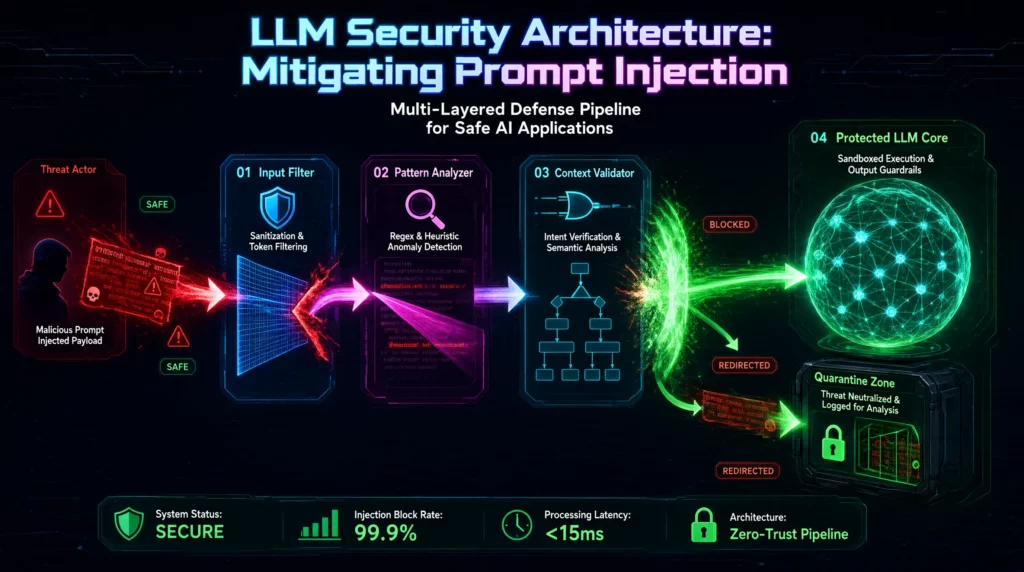
Si solo puedes implementar una medida de este artículo, implementa esta. Un policy gateway es un servicio intermedio que intercepta cada llamada a herramienta propuesta por el LLM, la valida contra políticas explícitas y decide si se ejecuta, se bloquea o requiere aprobación humana.
LLM → [propone tool_call] → Policy Gateway → [valida] → Tool real
                                  ↓
[rechaza + log]El agente nunca llama a la herramienta real directamente. El gateway es determinista (reglas, listas, límites), no otro LLM. Y es fail-closed: si hay cualquier duda o error, deniega.
Ejemplo práctico: gateway en Python + FastAPI
El siguiente ejemplo cubre las tres capas que más importan: allowlist de herramientas, mínimo privilegio por rol y saneamiento de argumentos. Es deliberadamente compacto para que puedas adaptarlo a tu stack.
"""
Policy Gateway para LLM.
Intercepta las llamadas a herramientas propuestas por el modelo,
valida permisos, aplica límites y decide si ejecutar, pedir confirmación o bloquear.
"""

from fastapi import FastAPI
from pydantic import BaseModel
from typing import Any, Literal
import json
import logging
import time
from datetime import datetime, timezone

app = FastAPI(title="LLM Policy Gateway")

# --- Configuración de políticas (en producción: cargar de YAML/DB, no hardcode) ---

TOOL_POLICIES = {
    "query_customer_db": {
        "risk": "low",
        "requires_confirmation": False,
        "allowed_roles": ["support", "admin"],
        "rate_limit_per_minute": 30,
        "max_rows": 100,
    },
    "send_email": {
        "risk": "medium",
        "requires_confirmation": True,   # acción externa → confirmación humana
        "allowed_roles": ["admin"],
        "rate_limit_per_minute": 5,
        "allowed_domains": ["@tuempresa.com"],
    },
    "execute_shell": {
        "risk": "high",
        "requires_confirmation": True,
        "allowed_roles": ["admin"],
        "rate_limit_per_minute": 2,
        "allowlist_commands": ["ls", "df", "uptime"],  # NADA de rm, curl, etc.
    },
}

# --- Modelos de request/response ---

class ToolCall(BaseModel):
    tool_name: str
    arguments: dict[str, Any]
    agent_id: str
    user_role: str
    session_id: str
    justification: str = ""  # el LLM debe explicar por qué quiere ejecutar la tool

class PolicyDecision(BaseModel):
    decision: Literal["allow", "confirm", "deny"]
    reason: str
    tool_name: str
    sanitized_arguments: dict[str, Any] | None = None
    requires_human_approval: bool = False
    audit_id: str | None = None

# --- Utilidades ---

logger = logging.getLogger("policy_gateway")
logging.basicConfig(level=logging.INFO)

def audit_log(entry: dict):
    """Registro estructurado para forense. En producción: enviar a SIEM."""
    entry["timestamp"] = datetime.now(timezone.utc).isoformat()
    logger.info(json.dumps(entry, ensure_ascii=False))

def sanitize_arguments(tool_name: str, args: dict[str, Any]) -> dict[str, Any]:
    """Limita y normaliza argumentos antes de ejecutar."""
    sanitized = dict(args)

    if tool_name == "query_customer_db":
        sanitized["limit"] = min(int(args.get("limit", 10)),
                                 TOOL_POLICIES[tool_name]["max_rows"])

    if tool_name == "send_email":
        to = args.get("to", "")
        allowed = TOOL_POLICIES[tool_name]["allowed_domains"]
        if not any(to.endswith(d) for d in allowed):
            raise ValueError(f"Dominio no permitido en 'to': {to}")

    if tool_name == "execute_shell":
        cmd = args.get("command", "").strip().split()[0] if args.get("command") else ""
        allowed_cmds = TOOL_POLICIES[tool_name]["allowlist_commands"]
        if cmd not in allowed_cmds:
            raise ValueError(f"Comando no permitido: {cmd}")

    return sanitized

# --- Endpoint principal ---

@app.post("/v1/tools/execute", response_model=PolicyDecision)
def evaluate_tool_call(call: ToolCall) -> PolicyDecision:
    audit_id = f"{call.session_id}-{int(time.time()*1000)}"
    policy = TOOL_POLICIES.get(call.tool_name)

    # 1. ¿La herramienta existe en la allowlist?
    if policy is None:
        audit_log({"audit_id": audit_id, "decision": "deny",
                   "reason": "tool_not_allowlisted", "tool": call.tool_name})
        return PolicyDecision(decision="deny", reason="Herramienta no permitida",
                              tool_name=call.tool_name, audit_id=audit_id)

    # 2. ¿El rol del usuario puede usar esta herramienta?
    if call.user_role not in policy["allowed_roles"]:
        audit_log({"audit_id": audit_id, "decision": "deny",
                   "reason": "role_not_allowed", "tool": call.tool_name,
                   "user": call.user_role})
        return PolicyDecision(decision="deny",
                              reason="Rol sin permiso para esta herramienta",
                              tool_name=call.tool_name, audit_id=audit_id)

    # 3. Saneamiento de argumentos
    try:
        sanitized = sanitize_arguments(call.tool_name, call.arguments)
    except ValueError as e:
        audit_log({"audit_id": audit_id, "decision": "deny",
                   "reason": f"sanitization_failed: {e}", "tool": call.tool_name})
        return PolicyDecision(decision="deny", reason=str(e),
                              tool_name=call.tool_name, audit_id=audit_id)

    # 4. ¿Requiere confirmación humana?
    if policy["requires_confirmation"]:
        audit_log({"audit_id": audit_id, "decision": "confirm",
                   "tool": call.tool_name, "args": sanitized,
                   "justification": call.justification})
        return PolicyDecision(decision="confirm",
                              reason="Acción requiere aprobación humana",
                              tool_name=call.tool_name,
                              sanitized_arguments=sanitized,
                              requires_human_approval=True,
                              audit_id=audit_id)

    # 5. Permitida
    audit_log({"audit_id": audit_id, "decision": "allow",
               "tool": call.tool_name, "args": sanitized})
    return PolicyDecision(decision="allow", reason="Permitida",
                          tool_name=call.tool_name,
sanitized_arguments=sanitized, audit_id=audit_id)Cómo lo usa el orquestador del agente
El LLM nunca llama a la herramienta real. El flujo correcto es:
import requests

def safe_tool_execution(tool_name: str, arguments: dict, agent_id: str,
                        user_role: str, session_id: str, justification: str):
    decision = requests.post("http://policy-gateway:8000/v1/tools/execute", json={
        "tool_name": tool_name,
        "arguments": arguments,
        "agent_id": agent_id,
        "user_role": user_role,
        "session_id": session_id,
        "justification": justification,
    }).json()

    if decision["decision"] == "deny":
        return {"status": "blocked", "reason": decision["reason"]}

    if decision["decision"] == "confirm":
        return {"status": "pending_approval",
                "audit_id": decision["audit_id"],
                "message": "Acción pendiente de aprobación humana"}

return execute_real_tool(decision["tool_name"], decision["sanitized_arguments"])Y en el prompt del sistema del agente se deja claro:
«Para usar cualquier herramienta debes llamar a
safe_tool_execution. No tienes acceso directo a la base de datos, al correo ni al shell. Si una acción es rechazada, no intentes rodearla: informa al usuario.»
Qué controla cada línea del gateway
| Control | Dónde está |
|---|---|
| Allowlist de herramientas | TOOL_POLICIES.get() → si no existe, deny |
| Mínimo privilegio por rol | call.user_role not in policy["allowed_roles"] |
| Saneamiento de argumentos | sanitize_arguments() con límites y allowlists |
| Confirmación humana | requires_confirmation → decision="confirm" |
| Trazabilidad / forense | audit_log() con audit_id y timestamp |
| Separación razonamiento/ejecución | El LLM propone, el gateway decide |
| Fail-closed | Cualquier excepción o tool desconocida → deny |
Notas de despliegue
- El gateway debe ser determinista. No uses otro LLM para validar al LLM: usa reglas, listas y políticas explícitas.
- Las políticas van versionadas (YAML o DB), no hardcodeadas. El ejemplo las tiene en un dict por legibilidad.
- El
audit_idse devuelve al orquestador para correlacionar con logs de aplicación y SIEM. - Fail-closed por defecto: si el gateway no responde o hay error de red, el orquestador debe tratar la llamada como
deny, nunca ejecutar directamente. - Rate limiting por herramienta y por sesión (Redis o
slowapien el ejemplo). - Este gateway protege la capa de herramientas, no la de entrada. El filtrado de prompts y la marca de contenido no confiable van en otra capa.
- Si el host donde corre el gateway está expuesto, protégelo también a nivel de sistema. Un
fail2banbien configurado es un complemento barato: cómo configurar y usar fail2ban para proteger tu servidor Linux.
5. Checklist de hardening antes de publicar un agente
Antes de poner un agente en producción, verifica:
- ¿Las herramientas del agente tienen permisos mínimos e independientes? Si el agente usa las mismas credenciales que tu usuario administrador, estás a un prompt injection de un incidente grave.
- ¿Las acciones de alto impacto tienen confirmación humana o policy gateway? El agente puede sugerir, pero no ejecutar sin validación.
- ¿El contenido externo está marcado como no confiable? El modelo debe saber qué es instrucción del sistema y qué es dato del usuario.
- ¿Hay logs completos de cada paso de razonamiento y llamada a herramienta? Sin esto, no puedes detectar abuso ni reconstruir un incidente.
- ¿Existe un kill switch o mecanismo de revocación inmediata? Si el agente empieza a comportarse de forma anómala, necesitas poder detenerlo sin desmontar toda la aplicación.
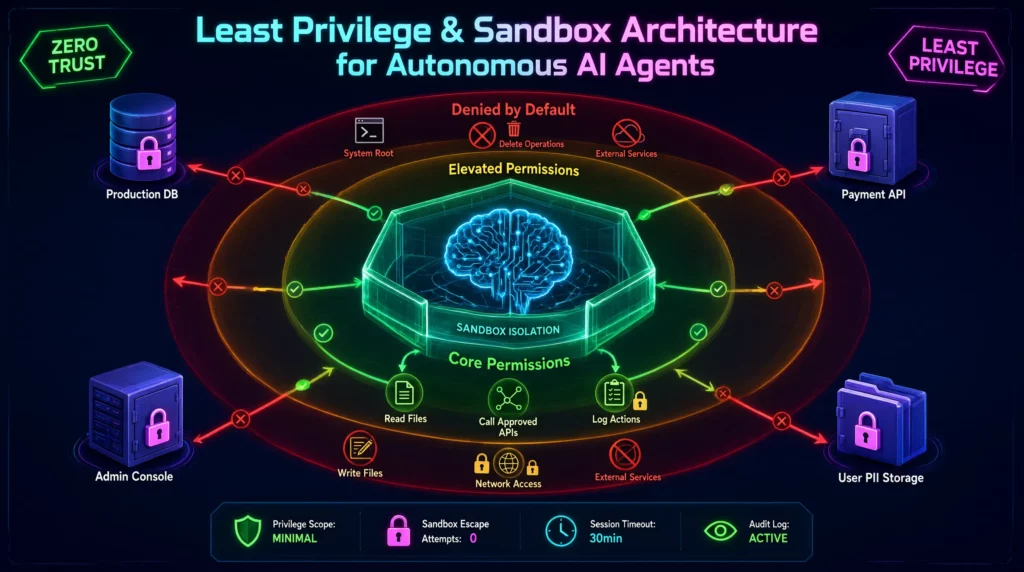
Regla de oro: el agente debe poder hacer su trabajo, pero no más. Permisos acotados = daño acotado.
6. Lo que aún no está resuelto (y debes asumir)
La seguridad de LLM sigue siendo un campo en maduración. Las mitigaciones actuales son mayoritariamente reactivas y se concentran en inferencia, mientras que los controles sobre pipelines de entrenamiento y comportamiento de sistemas autónomos son menos maduros y estandarizados.
Esto significa que debes diseñar asumiendo que algún control fallará. La pregunta no es «¿puede ocurrir un prompt injection?», sino «cuando ocurra, ¿qué puede hacer el atacante y cómo lo detecto?».
Preguntas frecuentes
¿Qué es un prompt injection?
Es un ataque en el que se introducen instrucciones maliciosas en el contexto del LLM (en un documento, una web o un correo) para que el modelo las ejecute como si fueran órdenes del sistema.
¿El OWASP Top 10 para LLM es obligatorio?
No es una norma legal, pero se ha convertido en el estándar de facto para priorizar riesgos en aplicaciones de IA generativa. Es la referencia que usan auditores y equipos de seguridad.
¿Cómo protejo un agente IA en producción?
Con defensa en capas: contenido externo marcado como no confiable, herramientas con permisos mínimos, un policy gateway determinista para acciones de alto impacto, confirmación humana y logs completos de cada paso.
¿Puedo usar otro LLM para validar al LLM principal?
No es recomendable como único control. Introduce latencia, coste y una nueva superficie de ataque. Usa reglas deterministas para lo crítico; reserva el LLM validador para tareas de clasificación no críticas.
Conclusión
Proteger un LLM en producción no es instalar un filtro mágico: es aplicar los mismos principios de siempre (mínimo privilegio, separación de responsabilidades, validación de entradas y salidas, trazabilidad) a un componente nuevo. El policy gateway es la pieza que más impacto tiene por unidad de esfuerzo, porque convierte «el modelo puede hacer cualquier cosa que le pidan» en «el modelo puede hacer exactamente lo que la política permite, y todo queda registrado».
Si estás empezando a desplegar agentes, empieza por ahí. Y si ya tienes uno en producción, revisa si hoy cumple el checklist de la sección 5. La mayoría de los incidentes con LLM no vienen de un ataque sofisticado, sino de un agente con más permisos de los que necesitaba.