📘 Este artículo forma parte de nuestra Guía Completa de Inteligencia Artificial 2026 y complementa a Cómo empezar con el aprendizaje profundo en Python. Si quieres dominar el deep learning, esas guías son tu punto de partida.
Introducción
Clasificar imágenes con IA ya no es un privilegio de grandes empresas con petabytes de datos y clústeres de GPUs. Gracias al transfer learning, hoy puedes crear un modelo de clasificación de imágenes de alta precisión con solo unos cientos de ejemplos y en menos de una hora.
El transfer learning (aprendizaje por transferencia) consiste en reutilizar un modelo preentrenado en un dataset enorme (ImageNet, COCO) y adaptarlo a tu problema específico. Es la técnica estándar en 2026 para:
- Clasificación médica (radiografías, dermatología).
- Control de calidad industrial (defectos en productos).
- Clasificación de plantas y animales.
- Reconocimiento de matrículas.
- Detección de fraudes visuales.
- Clasificación de documentos.
- Moderación de contenido.
- Retail (reconocimiento de productos).
En esta guía completa vas a aprender:
- Qué es el transfer learning y por qué funciona.
- Cuándo usarlo (y cuándo no).
- Arquitecturas recomendadas (ResNet, EfficientNet, ViT).
- Preparación del dataset (estructura, aumento de datos).
- Entrenamiento paso a paso con PyTorch.
- Fine-tuning vs feature extraction.
- Evaluación y métricas clave.
- Despliegue en producción.
- Optimización de rendimiento.
- FAQ con las preguntas más frecuentes.
Si eres nuevo en Python, consulta Aprende a programar en Python desde cero. Si quieres la teoría de redes neuronales, nuestra Guía de redes neuronales.
Índice de contenidos
- Qué es el transfer learning
- Por qué funciona tan bien
- Cuándo usarlo (y cuándo no)
- Arquitecturas recomendadas
- Requisitos y configuración
- Preparar el dataset
- Data augmentation
- Feature extraction vs fine-tuning
- Entrenamiento paso a paso
- Evaluación del modelo
- Despliegue en producción
- Optimización y mejoras
- Errores comunes
- FAQ
- Conclusión
1. Qué es el transfer learning
El transfer learning es una técnica de machine learning que reutiliza un modelo entrenado en una tarea para resolver una tarea diferente pero relacionada.
1.1 Idea fundamental
Problema: entrenar una red neuronal desde cero requiere:
- Millones de imágenes etiquetadas.
- GPUs potentes durante días o semanas.
- Expertise en ML.
- Presupuesto elevado.
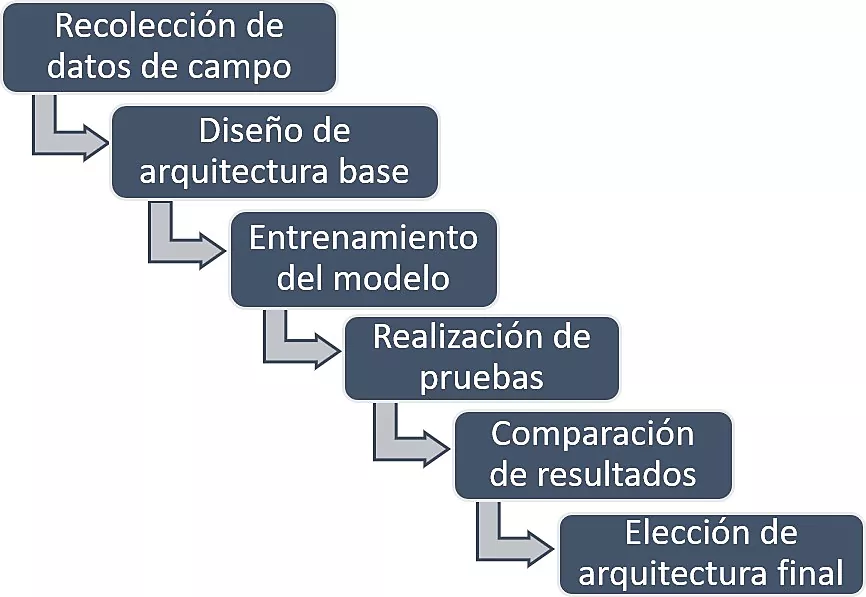
Solución: partir de un modelo ya entrenado en un dataset enorme (ImageNet con 14M imágenes y 1.000 clases) y adaptarlo a tu problema.
1.2 Analogía
Imagina que aprendes a conducir un coche. Cuando luego aprendes a conducir un camión, no empiezas de cero: ya sabes girar, frenar, cambiar marchas. Solo necesitas adaptar lo aprendido.
El transfer learning funciona igual: las primeras capas de una red neuronal aprenden características genéricas (bordes, formas, texturas) que son útiles para cualquier tarea visual. Las últimas capas aprenden características específicas que sí hay que reentrenar.
1.3 Historia
- 2012: AlexNet gana ImageNet.
- 2014: VGG y GoogLeNet demuestran la transferencia.
- 2015: ResNet con 152 capas.
- 2019: EfficientNet.
- 2020: Vision Transformers (ViT).
- 2026: transfer learning es estándar de facto.
Consulta Redes neuronales explicadas.
2. Por qué funciona tan bien
2.1 Jerarquía de características
Las redes convolucionales aprenden en capas:
- Primeras capas: bordes, líneas, colores.
- Capas medias: formas, texturas, patrones.
- Últimas capas: objetos completos, conceptos.
Las primeras capas son universales. Sirven para cualquier tarea visual.
2.2 Ventajas del transfer learning
- Menos datos: 100-1.000 imágenes por clase (vs. 1M+).
- Menos tiempo: minutos en lugar de días.
- Menos recursos: una GPU modesta es suficiente.
- Mejor precisión: en muchos casos supera a entrenar desde cero.
- Menos overfitting: con pocos datos.
2.3 Cuándo es especialmente efectivo
- Datasets pequeños (< 10.000 imágenes).
- Dominios relacionados con el modelo original.
- Tareas visuales (clasificación, detección).
- Prototipado rápido.
2.4 Datos que lo confirman
- +80% de proyectos de visión usan transfer learning.
- +90% de papers de clasificación médica lo usan.
- Reducción de datos: de millones a cientos.
3. Cuándo usarlo (y cuándo no)
3.1 Cuándo SÍ usarlo
- Dataset pequeño (< 10.000 imágenes).
- Dominio similar a ImageNet (objetos cotidianos).
- Clasificación de imágenes.
- Prototipado rápido.
- Producción con recursos limitados.
3.2 Cuándo NO usarlo
- Dominio muy distinto (imágenes médicas específicas, imágenes satelitales especializadas).
- Datasets masivos (> 100.000 imágenes por clase).
- Tareas no visuales (NLP, audio).
- Restricciones regulatorias sobre modelos preentrenados.
- Necesitas control total del modelo.
Nota: incluso en dominios distintos, el transfer learning suele funcionar mejor que entrenar desde cero.
4. Arquitecturas recomendadas
4.1 Clásicas (CNN)
ResNet-50:
- 50 capas.
- Estándar en muchas tareas.
- Rendimiento sólido.
- 25M parámetros.
ResNet-101:
- 101 capas.
- Más potente que ResNet-50.
- 45M parámetros.
EfficientNet-B0 a B7:
- Eficiencia excepcional.
- Familia escalable.
- Recomendado en 2026.
- 5-66M parámetros.
VGG-16 / VGG-19:
- Clásico.
- Más pesado.
- 138M parámetros.
4.2 Modernas (Transformers)
Vision Transformer (ViT):
- Basado en Transformers.
- Excelente con muchos datos.
- ViT-Base: 86M parámetros.
- Requiere más datos para fine-tuning.
Swin Transformer:
- ViT jerárquico.
- Muy eficiente.
- Rendimiento excelente.
ConvNeXt:
- CNN moderna con ideas de Transformers.
- Excelente rendimiento.
4.3 Tabla comparativa
| Modelo | Parámetros | Precisión (ImageNet) | Velocidad | Ideal para |
|---|---|---|---|---|
| ResNet-50 | 25M | 76% | Media | Estándar |
| ResNet-101 | 45M | 78% | Media | Más precisión |
| EfficientNet-B0 | 5M | 77% | Rápida | Eficiencia |
| EfficientNet-B4 | 19M | 83% | Media | Equilibrio |
| EfficientNet-B7 | 66M | 84% | Lenta | Máxima precisión |
| ViT-Base | 86M | 84% | Rápida | Datos abundantes |
| ConvNeXt-B | 89M | 84% | Media | Moderno |
4.4 Recomendaciones 2026
- Empieza con: EfficientNet-B0 o ResNet-50.
- Más precisión: EfficientNet-B4.
- Datos abundantes: ViT-Base o ConvNeXt.
- Producción móvil: MobileNetV3 o EfficientNet-Lite.
Consulta Redes neuronales explicadas.
5. Requisitos y configuración
5.1 Hardware
Mínimo:
- CPU: 4 núcleos.
- RAM: 8 GB.
- GPU: opcional (funciona en CPU, pero lento).
- Disco: 20 GB.
Recomendado:
- GPU: NVIDIA RTX 3060 12GB o superior.
- RAM: 16-32 GB.
- Disco: SSD NVMe.
Ideal:
- GPU: RTX 4090, A100.
- RAM: 64 GB+.
Consulta CUDA y cuDNN en Ubuntu y PyTorch para CUDA.
5.2 Software
Python 3.10+ con las siguientes librerías:
pip install torch torchvision torchaudio
pip install numpy pandas matplotlib scikit-learn
pip install pillow tqdm tensorboard
pip install timm <em># Modelos preentrenados</em>Verificar GPU:
import torch
print(torch.cuda.is_available())
print(torch.cuda.get_device_name(0) if torch.cuda.is_available() else "CPU")5.3 Entorno virtual
python3 -m venv venv
source venv/bin/activate
pip install -r requirements.txt5.4 Estructura del proyecto
proyecto/
├── data/
│   ├── train/
│   │   ├── clase1/
│   │   ├── clase2/
│   │   └── clase3/
│   ├── val/
│   │   ├── clase1/
│   │   ├── clase2/
│   │   └── clase3/
│   └── test/
│       ├── clase1/
│       ├── clase2/
│       └── clase3/
├── models/
├── notebooks/
├── src/
│   ├── dataset.py
│   ├── model.py
│   ├── train.py
│   └── evaluate.py
├── requirements.txt
└── README.mdConsulta Cómo instalar JupyterLab en Ubuntu si trabajas con notebooks.
6. Preparar el dataset
6.1 Estructura de carpetas
PyTorch espera esta estructura:
data/
├── train/
│   ├── gato/
│   │   ├── gato_01.jpg
│   │   ├── gato_02.jpg
│   │   └── ...
│   ├── perro/
│   │   └── ...
│   └── pajaro/
│       └── ...
└── val/
    ├── gato/
    ├── perro/
└── pajaro/Regla: una carpeta por clase.
6.2 Cantidad de datos
Recomendaciones:
- Mínimo: 50-100 imágenes por clase.
- Recomendado: 500-1.000 por clase.
- Ideal: 1.000+ por clase.
Con transfer learning, 100-500 imágenes por clase pueden ser suficientes.
6.3 Cargar datos con PyTorch
from torchvision import datasets, transforms
from torch.utils.data import DataLoader

# Transformaciones
train_transform = transforms.Compose([
    transforms.Resize((224, 224)),
    transforms.RandomHorizontalFlip(),
    transforms.RandomRotation(10),
    transforms.ColorJitter(brightness=0.2, contrast=0.2),
    transforms.ToTensor(),
    transforms.Normalize(
        mean=[0.485, 0.456, 0.406],
        std=[0.229, 0.224, 0.225]
    )
])

val_transform = transforms.Compose([
    transforms.Resize((224, 224)),
    transforms.ToTensor(),
    transforms.Normalize(
        mean=[0.485, 0.456, 0.406],
        std=[0.229, 0.224, 0.225]
    )
])

# Datasets
train_dataset = datasets.ImageFolder('data/train', transform=train_transform)
val_dataset = datasets.ImageFolder('data/val', transform=val_transform)

# DataLoaders
train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True, num_workers=4)
val_loader = DataLoader(val_dataset, batch_size=32, shuffle=False, num_workers=4)

# Clases
print(f"Clases: {train_dataset.classes}")
print(f"Imágenes train: {len(train_dataset)}")
print(f"Imágenes val: {len(val_dataset)}")6.4 Verificar datos
import matplotlib.pyplot as plt

# Mostrar algunas imágenes
images, labels = next(iter(train_loader))
fig, axes = plt.subplots(2, 4, figsize=(12, 6))
for i, ax in enumerate(axes.flat):
    img = images[i].permute(1, 2, 0).numpy()
    img = img * [0.229, 0.224, 0.225] + [0.485, 0.456, 0.406]  <em># Desnormalizar</em>
    img = img.clip(0, 1)
    ax.imshow(img)
    ax.set_title(train_dataset.classes[labels[i]])
    ax.axis('off')
plt.show()6.5 Calidad de los datos
Checklist:
- □ Imágenes correctamente etiquetadas.
- □ Resoluciones consistentes.
- □ Balance de clases.
- □ Sin imágenes duplicadas.
- □ Sin ruido (imágenes corruptas).
Consulta Cómo crear conjuntos de datos etiquetados de alta calidad.
7. Data augmentation
7.1 Qué es
Aumentar el dataset con transformaciones aleatorias para:
- Evitar overfitting.
- Mejorar generalización.
- Simular variaciones del mundo real.
7.2 Transformaciones comunes
from torchvision import transforms

train_transform = transforms.Compose([
    transforms.Resize((256, 256)),
    transforms.RandomResizedCrop(224),
    transforms.RandomHorizontalFlip(),
    transforms.RandomVerticalFlip(p=0.1),
    transforms.RandomRotation(15),
    transforms.ColorJitter(
        brightness=0.3,
        contrast=0.3,
        saturation=0.3,
        hue=0.1
    ),
    transforms.RandomAffine(degrees=0, translate=(0.1, 0.1)),
    transforms.ToTensor(),
    transforms.Normalize(
        mean=[0.485, 0.456, 0.406],
        std=[0.229, 0.224, 0.225]
    ),
    transforms.RandomErasing(p=0.2)
])7.3 Bibliotecas avanzadas
Albumentations:
import albumentations as A
from albumentations.pytorch import ToTensorV2

transform = A.Compose([
    A.Resize(224, 224),
    A.HorizontalFlip(p=0.5),
    A.Rotate(limit=15, p=0.5),
    A.RandomBrightnessContrast(p=0.3),
    A.GaussNoise(p=0.2),
    A.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),
    ToTensorV2()
])Ventajas: más transformaciones, mejor rendimiento.
7.4 Cuánto augmentation
- Dataset pequeño (< 500/clase): augmentation agresivo.
- Dataset medio (500-2.000): augmentation moderado.
- Dataset grande (> 2.000): augmentation suave.
7.5 Mixup y CutMix
Técnicas avanzadas que mezclan imágenes:
from timm.data import Mixup

mixup_fn = Mixup(
    mixup_alpha=0.2,
    cutmix_alpha=1.0,
    prob=0.5,
    num_classes=len(train_dataset.classes)
)Ventaja: mejor generalización.
8. Feature extraction vs fine-tuning
Dos estrategias según cantidad de datos y similitud del dominio.
8.1 Feature extraction
Qué es: congela el modelo preentrenado y solo entrena la última capa (clasificador).
Cuándo usar:
- Dataset muy pequeño (< 500 imágenes por clase).
- Dominio similar a ImageNet.
- Recursos limitados.
- Prototipado rápido.
Ventajas:
- Rápido (minutos).
- Menos overfitting.
- Menos recursos.
Ejemplo:
import torch.nn as nn
from torchvision import models

# Cargar modelo preentrenado
model = models.efficientnet_b0(weights='IMAGENET1K_V1')

# Congelar todas las capas
for param in model.parameters():
    param.requires_grad = False

# Reemplazar el clasificador
num_features = model.classifier[1].in_features
model.classifier[1] = nn.Linear(num_features, len(train_dataset.classes))

# Solo el clasificador se entrena8.2 Fine-tuning
Qué es: descongela algunas o todas las capas y las reentrena con tasa de aprendizaje baja.
Cuándo usar:
- Dataset mediano/grande (> 1.000 imágenes por clase).
- Dominio distinto de ImageNet.
- Buscas máxima precisión.
Ventajas:
- Mejor precisión.
- Adaptación al dominio.
Ejemplo:
# Descongelar las últimas capas
for param in model.features[-3:].parameters():
    param.requires_grad = True

# O descongelar todo
for param in model.parameters():
param.requires_grad = True8.3 Fine-tuning progresivo
Estrategia híbrida:
- Primera fase: solo clasificador (10 epochs).
- Segunda fase: descongelar últimas capas (5 epochs).
- Tercera fase: descongelar todo (5 epochs).
Ventaja: mejor convergencia y precisión.
8.4 Tabla resumen
| Aspecto | Feature extraction | Fine-tuning |
|---|---|---|
| Datos | < 500/clase | > 1.000/clase |
| Dominio | Similar | Distinto |
| Tiempo | Minutos | Horas |
| Recursos | Bajos | Medios |
| Precisión | Buena | Excelente |
| Overfitting | Bajo | Riesgo |
9. Entrenamiento paso a paso
9.1 Script completo
import torch
import torch.nn as nn
import torch.optim as optim
from torchvision import datasets, transforms, models
from torch.utils.data import DataLoader
from tqdm import tqdm

# Configuración
DEVICE = torch.device("cuda" if torch.cuda.is_available() else "cpu")
EPOCHS = 20
BATCH_SIZE = 32
LEARNING_RATE = 1e-3
NUM_CLASSES = 3

# Transformaciones
train_transform = transforms.Compose([
    transforms.Resize((224, 224)),
    transforms.RandomHorizontalFlip(),
    transforms.RandomRotation(10),
    transforms.ColorJitter(brightness=0.2, contrast=0.2),
    transforms.ToTensor(),
    transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])
])

val_transform = transforms.Compose([
    transforms.Resize((224, 224)),
    transforms.ToTensor(),
    transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])
])

# Datasets
train_dataset = datasets.ImageFolder('data/train', transform=train_transform)
val_dataset = datasets.ImageFolder('data/val', transform=val_transform)

train_loader = DataLoader(train_dataset, batch_size=BATCH_SIZE, shuffle=True, num_workers=4)
val_loader = DataLoader(val_dataset, batch_size=BATCH_SIZE, shuffle=False, num_workers=4)

# Modelo
model = models.efficientnet_b0(weights='IMAGENET1K_V1')

# Congelar capas
for param in model.parameters():
    param.requires_grad = False

# Reemplazar clasificador
num_features = model.classifier[1].in_features
model.classifier[1] = nn.Linear(num_features, NUM_CLASSES)

model = model.to(DEVICE)

# Optimizador y pérdida
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.classifier.parameters(), lr=LEARNING_RATE)
scheduler = optim.lr_scheduler.ReduceLROnPlateau(
    optimizer, mode='min', factor=0.5, patience=3
)

# Entrenamiento
best_val_acc = 0.0

for epoch in range(EPOCHS):
    # Train
    model.train()
    train_loss = 0.0
    train_correct = 0
    train_total = 0

    for images, labels in tqdm(train_loader, desc=f"Epoch {epoch+1}/{EPOCHS}"):
        images, labels = images.to(DEVICE), labels.to(DEVICE)

        optimizer.zero_grad()
        outputs = model(images)
        loss = criterion(outputs, labels)
        loss.backward()
        optimizer.step()

        train_loss += loss.item()
        _, predicted = outputs.max(1)
        train_total += labels.size(0)
        train_correct += predicted.eq(labels).sum().item()

    train_acc = 100.0 * train_correct / train_total
    train_loss /= len(train_loader)

    # Val
    model.eval()
    val_loss = 0.0
    val_correct = 0
    val_total = 0

    with torch.no_grad():
        for images, labels in val_loader:
            images, labels = images.to(DEVICE), labels.to(DEVICE)
            outputs = model(images)
            loss = criterion(outputs, labels)

            val_loss += loss.item()
            _, predicted = outputs.max(1)
            val_total += labels.size(0)
            val_correct += predicted.eq(labels).sum().item()

    val_acc = 100.0 * val_correct / val_total
    val_loss /= len(val_loader)

    scheduler.step(val_loss)

    print(f"Epoch {epoch+1}: "
          f"Train Loss: {train_loss:.4f}, Train Acc: {train_acc:.2f}%, "
          f"Val Loss: {val_loss:.4f}, Val Acc: {val_acc:.2f}%")

   # Guardar mejor modelo
    if val_acc > best_val_acc:
        best_val_acc = val_acc
        torch.save(model.state_dict(), 'models/best_model.pth')
        print(f"✓ Nuevo mejor modelo guardado (val_acc: {val_acc:.2f}%)")

print(f"\nMejor precisión: {best_val_acc:.2f}%")9.2 Fine-tuning adicional
# Descongelar las últimas capas
for param in model.features[-3:].parameters():
    param.requires_grad = True

# Nuevo optimizador con learning rate más bajo
optimizer = optim.Adam([
    {'params': model.features[-3:].parameters(), 'lr': 1e-5},
    {'params': model.classifier.parameters(), 'lr': 1e-3}
])

# Reentrenar
# ... (mismo loop)9.3 TensorBoard
from torch.utils.tensorboard import SummaryWriter

writer = SummaryWriter('runs/experiment_1')

# En el loop
writer.add_scalar('Loss/train', train_loss, epoch)
writer.add_scalar('Loss/val', val_loss, epoch)
writer.add_scalar('Accuracy/train', train_acc, epoch)
writer.add_scalar('Accuracy/val', val_acc, epoch)

writer.close()Ver:
tensorboard --logdir runs/9.4 Early stopping
patience = 5
epochs_without_improvement = 0

# En el loop
if val_acc > best_val_acc:
    best_val_acc = val_acc
    epochs_without_improvement = 0
    torch.save(model.state_dict(), 'models/best_model.pth')
else:
    epochs_without_improvement += 1
    if epochs_without_improvement >= patience:
        print(f"Early stopping en epoch {epoch+1}")
break9.5 Mixed precision (más rápido)
from torch.cuda.amp import autocast, GradScaler

scaler = GradScaler()

for images, labels in train_loader:
    optimizer.zero_grad()

    with autocast():
        outputs = model(images)
        loss = criterion(outputs, labels)

    scaler.scale(loss).backward()
    scaler.step(optimizer)
scaler.update()Ventaja: 2x más rápido, menos memoria.
9.6 Guardar y cargar el modelo
# Guardar
torch.save({
    'model_state_dict': model.state_dict(),
    'optimizer_state_dict': optimizer.state_dict(),
    'epoch': epoch,
    'best_val_acc': best_val_acc,
    'classes': train_dataset.classes
}, 'models/checkpoint.pth')

# Cargar
checkpoint = torch.load('models/best_model.pth')
model.load_state_dict(checkpoint['model_state_dict'])
classes = checkpoint['classes']Consulta PyTorch para CUDA.
10. Evaluación del modelo
10.1 Métricas clave
Accuracy:
- % de predicciones correctas.
- Útil con clases balanceadas.
Precision:
- De los positivos predichos, cuántos son correctos.
Recall:
- De los positivos reales, cuántos detectó.
F1-score:
- Media armónica de precision y recall.
Confusion matrix:
- Matriz que muestra errores por clase.
10.2 Evaluación en test
from sklearn.metrics import classification_report, confusion_matrix
import numpy as np

model.eval()
all_preds = []
all_labels = []

with torch.no_grad():
    for images, labels in val_loader:
        images, labels = images.to(DEVICE), labels.to(DEVICE)
        outputs = model(images)
        _, predicted = outputs.max(1)

        all_preds.extend(predicted.cpu().numpy())
        all_labels.extend(labels.cpu().numpy())

# Reporte
print(classification_report(
    all_labels, all_preds,
    target_names=train_dataset.classes
))
# Matriz de confusión
cm = confusion_matrix(all_labels, all_preds)
print(cm)10.3 Visualizar confusion matrix
import seaborn as sns

plt.figure(figsize=(10, 8))
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues',
            xticklabels=train_dataset.classes,
            yticklabels=train_dataset.classes)
plt.xlabel('Predicción')
plt.ylabel('Real')
plt.title('Matriz de confusión')
plt.show()10.4 Ejemplo de salida
              precision    recall  f1-score   support

        gato       0.95      0.93      0.94       100
       perro       0.92      0.96      0.94       100
      pajaro       0.97      0.94      0.95       100

    accuracy                           0.94       300
   macro avg       0.95      0.94      0.94       300
weighted avg 0.95 0.94 0.94 30094% de accuracy con solo 300 imágenes de test.
10.5 Análisis de errores
# Ver imágenes mal clasificadas
model.eval()
wrong_indices = []

with torch.no_grad():
    for i, (image, label) in enumerate(val_dataset):
        image_tensor = image.unsqueeze(0).to(DEVICE)
        output = model(image_tensor)
        _, pred = output.max(1)

        if pred.item() != label:
            wrong_indices.append(i)

# Mostrar errores
for idx in wrong_indices[:8]:
    image, label = val_dataset[idx]
    plt.figure()
    plt.imshow(image.permute(1, 2, 0) * [0.229, 0.224, 0.225] + [0.485, 0.456, 0.406])
    plt.title(f"Real: {train_dataset.classes[label]}")
plt.show()11. Despliegue en producción
11.1 Exportar el modelo
TorchScript:
model.eval()
example_input = torch.rand(1, 3, 224, 224).to(DEVICE)
traced_model = torch.jit.trace(model, example_input)
traced_model.save('models/model_traced.pt')ONNX:
torch.onnx.export(
    model,
    example_input,
    "models/model.onnx",
    input_names=['input'],
    output_names=['output'],
    dynamic_axes={'input': {0: 'batch_size'}, 'output': {0: 'batch_size'}}
)Ventaja ONNX: interoperabilidad con otros frameworks.
11.2 FastAPI
from fastapi import FastAPI, UploadFile, File
from PIL import Image
import torch
import io

app = FastAPI()

# Cargar modelo
model = models.efficientnet_b0()
model.classifier[1] = nn.Linear(model.classifier[1].in_features, NUM_CLASSES)
model.load_state_dict(torch.load('models/best_model.pth'))
model.eval()
model = model.to(DEVICE)

# Transformaciones
transform = transforms.Compose([
    transforms.Resize((224, 224)),
    transforms.ToTensor(),
    transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])
])

@app.post("/predict")
async def predict(file: UploadFile = File(...)):
    # Cargar imagen
    image_bytes = await file.read()
    image = Image.open(io.BytesIO(image_bytes)).convert('RGB')

    # Preprocesar
    image_tensor = transform(image).unsqueeze(0).to(DEVICE)

    # Predecir
    with torch.no_grad():
        outputs = model(image_tensor)
        probabilities = torch.softmax(outputs, dim=1)
        confidence, predicted = probabilities.max(1)

    # Resultado
    return {
        "class": classes[predicted.item()],
        "confidence": float(confidence.item()),
        "probabilities": {
            classes[i]: float(probabilities[0][i].item())
            for i in range(len(classes))
        }
    }

# Ejecutar: uvicorn main:app --host 0.0.0.0 --port 800011.3 Docker
Dockerfile:
FROM python:3.11-slim

WORKDIR /app

COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

COPY . .

EXPOSE 8000

CMD ["uvicorn", "main:app", "--host", "0.0.0.0", "--port", "8000"]docker-compose.yml:
version: '3.8'
services:
  api:
    build: .
    ports:
      - "8000:8000"
    volumes:
      - ./models:/app/models
restart: unless-stoppedConsulta Qué es Docker.
11.4 Optimización para producción
Quantization:
import torch.quantization as quant

model.eval()
model.qconfig = torch.quantization.get_default_qconfig('fbgemm')
quant.prepare(model, inplace=True)
# Calibrar con datos
quant.convert(model, inplace=True)Ventaja: 4x más pequeño, 2-3x más rápido en CPU.
Pruning:
import torch.nn.utils.prune as prune

# Poda del 20%
for module in model.modules():
    if isinstance(module, nn.Conv2d):
prune.l1_unstructured(module, name='weight', amount=0.2)TensorRT (NVIDIA):
- Optimización para GPUs NVIDIA.
- 2-5x más rápido.
Consulta CUDA y cuDNN.
11.5 Despliegue en cloud
Opciones:
- AWS SageMaker.
- Azure ML.
- Google Vertex AI.
- Hugging Face Spaces.
- Replicate.
- RunPod.
Consulta Introducción a Azure.
12. Optimización y mejoras
12.1 Mejorar precisión
- Más datos.
- Data augmentation.
- Fine-tuning progresivo.
- Ensemble de modelos.
- Test-time augmentation.
- Modelos más grandes.
12.2 Reducir overfitting
- Más datos.
- Data augmentation.
- Dropout.
- Weight decay.
- Early stopping.
- Modelos más pequeños.
12.3 Acelerar entrenamiento
- Mixed precision.
- Batch size más grande.
- GPUs más potentes.
- DataLoader optimizado.
- Preprocesamiento en paralelo.
12.4 Ensemble de modelos
# Combinar predicciones de varios modelos
predictions = []
for model in models:
    with torch.no_grad():
        output = model(images)
        predictions.append(torch.softmax(output, dim=1))

# Promedio
final_pred = torch.stack(predictions).mean(dim=0)Ventaja: +2-5% de precisión.
12.5 Test-time augmentation
# Aplicar múltiples transformaciones y promediar
augmentations = [flip, rotate, crop]
predictions = []

for aug in augmentations:
    aug_images = aug(images)
    with torch.no_grad():
        output = model(aug_images)
        predictions.append(torch.softmax(output, dim=1))

final = torch.stack(predictions).mean(dim=0)13. Errores comunes
13.1 «CUDA out of memory»
Solución:
- Reducir batch size.
- Usar mixed precision.
- Modelo más pequeño.
- Gradient accumulation.
13.2 «Model not learning»
Causas:
- Learning rate incorrecto.
- Datos mal etiquetados.
- Modelo congelado.
Solución:
- Verificar learning rate.
- Revisar datos.
- Verificar
requires_grad.
13.3 «Overfitting desde epoch 1»
Causas:
- Muy pocos datos.
- Sin augmentation.
- Modelo demasiado grande.
Solución:
- Más datos o augmentation.
- Modelo más pequeño.
- Regularización.
13.4 «Val accuracy no mejora»
Causas:
- Learning rate muy alto.
- Datos de validación distintos.
- Clases desbalanceadas.
Solución:
- Reducir learning rate.
- Verificar val set.
- Weighted loss.
13.5 «Predicciones siempre la misma clase»
Causas:
- Datos desbalanceados.
- Modelo colapsado.
- Loss function incorrecta.
Solución:
- Balancear clases.
- Reiniciar entrenamiento.
- Verificar loss.
13.6 «Muy lento en CPU»
Solución:
- Usar GPU.
- Reducir resolución.
- Modelo más pequeño.
- Quantization.
13.7 «Falsos positivos en producción»
Causas:
- Dataset no representativo.
- Data drift.
- Overfitting.
Solución:
- Más datos diversos.
- Monitorear drift.
- Reentrenar periódicamente.
13.8 «Modelo no generaliza»
Causas:
- Datos sesgados.
- Poca variedad.
- Overfitting.
Solución:
- Datos más diversos.
- Augmentation.
- Regularización.
Consulta La importancia del equilibrio de clases en el entrenamiento de IA.
14. FAQ
¿Qué es el transfer learning?
Transfer learning es una técnica que reutiliza un modelo preentrenado en un dataset grande (ImageNet) y lo adapta a un problema específico.
Ventaja: menos datos, menos tiempo, mejor precisión.
¿Cuántas imágenes necesito para transfer learning?
Recomendaciones:
- Mínimo: 50-100 por clase.
- Recomendado: 500-1.000 por clase.
- Ideal: 1.000+ por clase.
Con transfer learning, 100-500 imágenes por clase pueden ser suficientes.
¿Qué modelo preentrenado uso?
Recomendaciones 2026:
- EfficientNet-B0: eficiencia y buena precisión.
- ResNet-50: estándar de la industria.
- EfficientNet-B4: mayor precisión.
- ViT-Base: si tienes muchos datos.
Empieza con EfficientNet-B0 o ResNet-50.
¿Feature extraction o fine-tuning?
Depende:
- Dataset pequeño (< 500/clase) → feature extraction.
- Dataset mediano/grande → fine-tuning.
- Dominio distinto → fine-tuning.
- Dominio similar → feature extraction.
¿Cuánto tiempo tarda entrenar?
Con GPU moderna:
- Feature extraction: 5-15 minutos.
- Fine-tuning completo: 30 min – 2 horas.
- Modelo grande: 2-8 horas.
En CPU: 5-20x más lento.
¿Necesito GPU?
No imprescindible, pero muy recomendable.
- CPU: funciona, pero lento.
- GPU: 10-50x más rápido.
Recomendación: GPU NVIDIA RTX 3060 o superior.
Consulta CUDA y cuDNN en Ubuntu.
¿Qué GPU necesito?
Recomendaciones:
- Mínimo: RTX 3060 12GB.
- Recomendado: RTX 4070 Ti, RTX 4080.
- Ideal: RTX 4090, A100.
GPU cloud: Google Colab, RunPod, Vast.ai.
¿Cómo preparo mi dataset?
Estructura:
data/
├── train/
│   ├── clase1/
│   ├── clase2/
│   └── clase3/
└── val/
    ├── clase1/
    ├── clase2/
└── clase3/Split recomendado:
- Train: 70-80%.
- Val: 10-15%.
- Test: 10-15%.
¿Qué es data augmentation?
Técnica que genera variaciones de tus imágenes para evitar overfitting:
- Rotaciones.
- Volteos.
- Cambios de brillo/contraste.
- Recortes aleatorios.
¿Cuánto data augmentation aplicar?
- Dataset pequeño: agresivo.
- Dataset mediano: moderado.
- Dataset grande: suave.
¿Cómo sé si mi modelo está overfitting?
Señales:
- Train accuracy muy alta.
- Val accuracy baja.
- Brecha grande entre train y val.
Solución: más datos, augmentation, regularización.
¿Cómo mejoro la precisión?
Técnicas:
- Más datos.
- Data augmentation.
- Fine-tuning progresivo.
- Ensemble.
- Test-time augmentation.
- Modelo más grande.
¿Cómo despliego el modelo?
Opciones:
- FastAPI: API REST.
- Docker: contenedor.
- Cloud: AWS SageMaker, Azure ML.
- Edge: TensorFlow Lite, ONNX.
Ejemplo: FastAPI + Docker + Cloud.
¿Qué es quantization?
Técnica que reduce la precisión de los pesos (FP32 → INT8) para:
- Modelo 4x más pequeño.
- 2-4x más rápido.
- Menor consumo de memoria.
Impacto: mínima pérdida de precisión.
¿Qué es ONNX?
Formato abierto para exportar modelos entre frameworks.
Ventaja: interoperabilidad (PyTorch → TensorFlow → C++).
¿Qué es TensorRT?
Framework de NVIDIA para optimizar modelos en GPUs.
Ventaja: 2-5x más rápido.
¿Puedo usar transfer learning para imágenes médicas?
Sí, con matices:
- Funciona mejor con dominios similares.
- Para radiología: usa modelos preentrenados en imágenes médicas (CheXpert).
- Data augmentation específico.
Consulta IA en la industria de la salud.
¿Cuántas capas descongelo en fine-tuning?
Estrategias:
- Conservadora: últimas 1-2 capas.
- Moderada: últimas 3-5 capas.
- Agresiva: todas las capas.
Recomendación: empieza conservador, aumenta si es necesario.
¿Qué learning rate uso?
Recomendaciones:
- Feature extraction: 1e-3.
- Fine-tuning: 1e-4 a 1e-5.
- Fine-tuning completo: 1e-5 a 1e-6.
Usa scheduler (ReduceLROnPlateau, CosineAnnealing).
¿Cómo manejo clases desbalanceadas?
Técnicas:
- Weighted loss.
- Oversampling de clases minoritarias.
- Undersampling de mayoritarias.
- Data augmentation para minoritarias.
- Focal loss.
Consulta La importancia del equilibrio de clases.
¿Qué es mixed precision?
Técnica que combina FP16 y FP32 para:
- 2x más rápido.
- Menos memoria.
- Misma precisión.
from torch.cuda.amp import autocast, GradScaler¿Cómo monitorizo el entrenamiento?
Herramientas:
- TensorBoard.
- Weights & Biases.
- MLflow.
- Comet ML.
Métricas: loss, accuracy, learning rate.
¿Qué es early stopping?
Técnica que detiene el entrenamiento si val loss/accuracy no mejora durante N epochs.
Ventaja: evita overfitting.
¿Cómo evalúo mi modelo?
Métricas:
- Accuracy.
- Precision.
- Recall.
- F1-score.
- Confusion matrix.
from sklearn.metrics import classification_report¿Cuál es la mejor arquitectura en 2026?
Recomendaciones:
- Eficiencia: EfficientNet-B0.
- Precisión: EfficientNet-B4/B7.
- Moderno: ConvNeXt, Swin Transformer.
- Datos abundantes: ViT-Base.
Empieza con EfficientNet-B0.
¿Puedo usar transfer learning en el móvil?
Sí:
- MobileNetV3.
- EfficientNet-Lite.
- TensorFlow Lite.
- Core ML (iOS).
Ventaja: modelos ligeros y rápidos.
¿Cómo reentreno mi modelo?
Estrategias:
- Reentrenar con nuevos datos.
- Fine-tuning con datos difíciles.
- Continual learning con nuevos datos.
Recomendación: reentrena periódicamente.
¿Qué es data drift?
Cambio en la distribución de datos de entrada.
Ejemplo: cámara con nueva iluminación, nueva resolución.
Solución: monitorizar, reentrenar.
¿Dónde consigo datasets?
Fuentes:
- Kaggle.
- Hugging Face Datasets.
- Papers with Code.
- ImageNet.
- Google Dataset Search.
Consulta Cómo acceder y analizar datasets públicos.
¿Cuánto cuesta entrenar en cloud?
Aproximado:
- Google Colab: gratis (T4) o 10 €/mes (Pro).
- RunPod: 0,2-1 €/hora.
- AWS: 0,5-3 €/hora.
- Vast.ai: 0,2-1 €/hora.
Total típico: 5-50 € por proyecto.
15. Conclusión
El transfer learning es la técnica más importante en visión por computador en 2026. Permite crear modelos de alta precisión con pocos datos, poco tiempo y recursos modestos.
Puntos clave:
- Transfer learning = reutilizar un modelo preentrenado.
- Ventajas: menos datos, tiempo y recursos.
- Arquitecturas: EfficientNet, ResNet, ViT.
- Estrategias: feature extraction vs fine-tuning.
- Dataset: mínimo 100-500 imágenes por clase.
- Data augmentation para evitar overfitting.
- Métricas: accuracy, precision, recall, F1.
- Despliegue: FastAPI, Docker, cloud.
- Optimización: quantization, pruning, TensorRT.
- Empieza con EfficientNet-B0 y fine-tuning progresivo.
Recomendación para empezar:
- Instala PyTorch con CUDA.
- Prepara tu dataset (carpetas por clase).
- Elige EfficientNet-B0 o ResNet-50.
- Feature extraction primero.
- Fine-tuning después.
- Evalúa con métricas correctas.
- Despliega con FastAPI + Docker.
Si quieres profundizar:
- Guía Completa de Inteligencia Artificial 2026
- Cómo empezar con el aprendizaje profundo en Python
- Redes neuronales explicadas
- Machine Learning: todo lo que debes saber
- La importancia del equilibrio de clases en IA
- Cómo crear conjuntos de datos etiquetados de alta calidad
- Cómo acceder y analizar datasets públicos
- PyTorch para CUDA 12.4
- CUDA y cuDNN en Ubuntu
- Cómo instalar JupyterLab en Ubuntu 24.04
- Qué es Docker
- IA en la industria de la salud
- Lenguajes de programación para IA